操作系统的边界在哪里

引言

哪里是操作系统?

Linux Kernel 的维护者说,提供Syscall的是操作系统。

汇编爱好者说,提供系统调用库函数的下面的是操作系统。

ArchLinux佳豪说,上面这些加上一些Terminal,一些Network Manager,和一个Pacman,就是操作系统。

Ubuntu用户说,这个桌面和内置的小软件以下是操作系统。

余承东说鸿蒙是操作系统。

正在许愿Vibe coding的文科生说,deepseek帮我复刻一些windowsxp。

操作系统的上面。

在内存中心呼唤系统的自陷

要找到操作系统的上边界,让我们深入所谓用户软件和操作系统在书上所定义的,发生切换的一瞬间。

目态与管态

要理解为什么会有“切换的瞬间”,就要知道为什么需要这么做,他们在切换什么。

另外的一组名字叫做用户态内核态,原因很简单,互联网上的软件千千万万,良莠不齐,需要给内核操作和用户操作彻底隔离开(不只是在两种状态,后面会提到)。包括系统指令的地址空间都是用户不可达的,需要让用户软件不触及操作系统的正常允许。

你也不想qq崩溃直接给系统拉闸了吧。

但是那些系统方法总得用吧,不能用户程序啥也不做,所以需要用一种特殊的方式来切换系统模式

系统调用

对于一般的程序员,能够碰到最下面的地方就是库函数,这里我们以c语言举例。

比如write()方法,write(fd, buf, count)

  1. 传递参数

首先这几个参数(标识符,写入内容地址头,长度)会被重写为汇编能识别的参数,然后调用write函数

mov     edx, 5
lea     rsi, [rip + hello]
mov     edi, 1
call    write

注意这下面的call是正常汇编的调用函数,此时PC的值改为call+指令长+偏移指向write函数开头。

返回地址(RSP)压入用户栈。此时我们的参数们还在刚才塞进去的寄存器里面。

  1. 执行系统调用

此时执行系统调用(ABI)前,必须填写以下的规范化系统调用参数,这个过程具体有点太具体了,远远超过了408会考察的范围,总之会把刚才的参数传递进去。

RAX = 系统调用号

RDI = 参数1 RSI = 参数2 RDX = 参数3 R10 = 参数4 R8 = 参数5 R9 = 参数6

在这一堆参数传递完毕后,终于到了那传说中操作系统的边界

syscall
  1. 硬件隐指令

首先硬件会自动关中断,保存现场(原始PSW),给原函数syscall的地址入栈(RCX=syscall地址+指令长)。

值得注意的是这个地方新旧系统并不一样,64位系统通常用MSR寄存器直接表明syscall的各种内核入口内存地址,但是32位老系统(也就是408)参考书上的农逼系统一般是通过中断向量寻址,查询IDT(中断描述符表)和中断向量号来寻找syscall的入口地址。考试建议假装是后者。

这个过程纯自动,然后开中断。

然后切换CPU模式,把CPL从3(用户)改为0(内核)。

  1. 取得参数

因为刚才已经往寄存器传递了参数,所以内核可以从寄存器取得这些参数的值。

  1. 内核函数真正执行

这个时候内核函数才开始真正执行write函数实际的内容,这里就不细讲了,和主题没啥关系。

  1. 恢复现场,返回用户态

此时把栈顶的保护现场的PC值出栈,PSW写回原来的样子,需要传回的参数也写入寄存器传回。

然后执行

sysretq

此时回到原始程序syscall的下一条位置。

之后从write函数的ret地址跳回write下一个指令位置,这个过程结束。

408辩经

值得注意的,考过的,这些系统调用的库函数并不是操作系统的边界,是他们的最后一行执行的syscall(农逼老电脑可能是INT)会切换到内核态执行系统调用。

操作系统的下面

硬件和OS的冒险 Episode00

相比上一个问题,这个问题就变得没有答案了,因为OS的底层和硬件深度耦合,不太可能清楚地分开。

我们用上面那个write的瞬间举例子

回到syscall发生的那一瞬间。

硬件隐指令

在syscall之后,硬件而非os开始接管。

切换内核态,关中断,保存寄存器,保存现场,压栈地址,跳到内核syscall开始的地方,这些步骤就是硬件自己执行的,在这之后才是OS执行的地方。

配置与自动

OS与硬件更多的是一种配置和自动执行的关系。

页表

比如所谓的内存管理。首先是操作系统来建立了你所见到的树上的页表,告诉了硬件虚实地址的映射关系,这就是配置

之后每次访存OS直接传递的就是虚拟地址而非物理地址,此时查表,地址转换都是硬件自动执行,但是,但是,如果缺页错误,将会调回操作系统执行缺页处理程序。

进程调度

又比如所谓调度过程,本质上并不是CPU自己知道什么时候该调度什么进程,相反的。

是OS通过定时器中断给CPU打入内核态,然后执行调度器,这个时候才决定要不要切换上下文,切换进程。

硬件中断

当外部控制器(I/O中断)发出中断的一瞬间,CPU停止当前程序,保存现场,找到中断向量表的入口,进入内核态,之后OS接入,执行USB驱动程序(或者别的什么驱动程序),驱动程序再来处理这个外部中断具体内容。

总结

不难发现OS对于上层的边界是非常非常清晰的,但是和硬件是揉在一起的。

但是这是假象,操作系统这个词语的边界在2026年绝对不是所谓syscall的一瞬间。
PythonSTG开发心路

前言

相关的文档参考详见

PySTG Docs
Python + OpenGL 东方 Project 风格弹幕射击游戏引擎文档

仓库地址在

GitHub - qwqpap/PythonSTG: Finally we find that python has invaded Touhou
Finally we find that python has invaded Touhou. Contribute to qwqpap/PythonSTG development by creating an account on GitHub.

这里还是主要介绍一下心路历程和技术细节啊嗯。

怎么来的

最开始想做这个的来源是2024年末想要用Luastg搓点好玩的弹幕小游戏在你矿1.5次例会上面玩,最开始就是一直用的Luastg,包括在2025年的时候在第二届百校天则大大方方卖的东方做题狙也是这么来的。

当时还非常非常原始,用Luastg的原版demo爆改了三面和一些ui贴图啥的就拿来卖,感觉也对不起当时花金币的游客。

之后就沉寂了很久,期间倒是一直有厚米催我更新,但是比较懒。

直到后面办九州拾遗,要做一个惊天地泣鬼神的牛逼stg,就想着直接整个重写一次得了,来接入Nonebot,其实现在想想我估计Luastg也能支持这个,但是总是有反复造轮子的快乐在里面的。

于是去年考研结束后就开始开发这个,最开始想法是用Rust做底层计算,再以一个Python库的形式供流程脚本调用,事后发现Rust的严格内存管理和我的狂放风格不是很搭边。

于是捡起来了大一用过的Numba+Numpy的组合直接在Python内部实现弹幕计算,惊人的,效率高到难以想象,甚至比Luastg和Zun自己的cpp引擎效率还要高得多。

这点让我很高兴。

高速的Python

GLI的罪恶

通常认为Python是非常低效的语言,因为使用了解释器导致无法预编译程序,所以效率瓶颈在解释器的执行速度上,所以在面对超大数组的遍历等操作时就会被别的非解释型语言拉开非常大的差距。

在多线程互锁行为中,Python提供了非常复古的GIL方式,通过上锁来确保每次访问机器码的只有一个进程,这还不是最卡顿的。

CPython采用了时间片轮转算法来控制各个进程的使用,并且每5ms就将当前执行之进程直接踹死到就绪队列,在本例的计算密集行为中,这种反复剥夺再重新分配同一个进程的行为使得高速计算直接不可使用。

亦有消息说Python正在大力推广No-GLI方法,我们静待花开。

于是我们引入两个高手工具:

Numpy与Numba让你的脚本飞起来

众所周知Python是弱类型语言,并且支持初始不指定类型,这在很多快速开发中很方便,但是在需要精确对其内存空间来实现数组操作的本例来说就炸飞了。

这里引入一小段碰撞检查的代码,其实大部分的计算都在这里。

@njit(cache=True)
def _check_player_vs_bullets(
    player_x: float, 
    player_y: float, 
    player_radius: float,
    bullet_pos: np.ndarray,  # shape: (N, 2)
    bullet_radius: np.ndarray,  # shape: (N,)
    bullet_alive: np.ndarray,  # shape: (N,)
) -> int:
    """
    检查玩家与子弹的碰撞(Numba加速)
Returns:
    碰撞的子弹索引,-1表示无碰撞
"""
n = bullet_pos.shape[0]
for i in range(n):
    if bullet_alive[i] == 0:
        continue
    
    dx = bullet_pos[i, 0] - player_x
    dy = bullet_pos[i, 1] - player_y
    dist_sq = dx * dx + dy * dy
    
    combined_r = player_radius + bullet_radius[i]
    if dist_sq < combined_r * combined_r:
        return i

return -1

我们以这个为例子

静态类型与局部性原理

通过直接在初始化时指定坐标的数据类型,这样在Numba编译时就会直接跳过查询这个变量类型的步骤,非常恐怖效率。

与此同时那个数组bullet_pos将会直接被作为整组数据装入内存的连续空间,具有极其友好的空间局部性。此时对于数组元素的访问将是极端快速的指针加减。效率不知道高到哪里去了。

对于单个子弹的两个坐标将是连续存放的,此时读取效率很高,在空间局部性下,所有的数据将会被直接放入缓存,直接省下一大笔访存时间。

投机取巧的神秘优化

在汇编语言中实现乘法是极其方便的,通过反复的位运算(幂次运算)与加法来实现乘法能够在可控的时钟周期内直接得出结果,然而开平方运算将会花掉非常多时间。

        dx = bullet_pos[i, 0] - player_x
dy = bullet_pos[i, 1] - player_y
dist_sq = dx * dx + dy * dy

    combined_r = player_radius + bullet_radius[i]
    if dist_sq < combined_r * combined_r:
        return i</code></pre><p>注意到这一坨,为了避免开平方,给需要比较的两端(其实是距离)同时平方,此时乘方效率远高于开方。</p><p>在引擎中我实现了处处都是用这样的数据流来达到<strong>最快</strong>的速度。理论上此时速度不会输给直接用c写。</p><h3 id="%E5%9C%A8%E5%A4%B1%E5%8E%BB%E4%BA%86%E7%AB%8B%E5%8D%B3%E6%B8%B2%E6%9F%93%E6%A8%A1%E5%BC%8F%E7%9A%84%E4%B8%96%E7%95%8C%E9%87%8C%EF%BC%8C%E7%A9%B6%E7%AB%9F%E4%BC%9A%E5%BC%80%E5%87%BA%E4%BB%80%E4%B9%88%E6%A0%B7%E9%A2%9C%E8%89%B2%E7%9A%84%E8%8A%B1%E6%9C%B5%E3%80%82">在失去了立即渲染模式的世界里,究竟会开出什么样颜色的花朵。</h3><p></p><p>因为同时要传输上万个弹幕的数据给显卡,所以我们同时需要做两件事情,第一,不要反复在cpu和gpu中间传递数据,做到 <strong>只绘制一次。</strong>第二,把疯狂的简单的大量坐标计算全部丢给GPU自己算去,来给CPU更新别的数据留出充分的时间。在Python中我们使用moderngl库来实现这一切。</p><h4 id="you-only-draw-once">You Only Draw Once</h4><p>如果每个子弹你都调用绘制,在上万个子弹出现时你的PCIE通道就会被大量重复数据日满,为了能够一次性把所有数据噗叽啪一下塞入显卡,需要一些神秘的优化。</p><pre><code class="language-python">        # 创建VAO
    self.vao = self.ctx.vertex_array(
        self.program,
        [
            (self.vertex_vbo, '2f 2f', 'in_vert', 'in_uv_base'),
            (self.position_vbo, '2f/i', 'in_offset'),
            (self.angle_vbo, '1f/i', 'in_angle'),
            (self.uv_vbo, '4f/i', 'in_uv_rect'),
            (self.scale_vbo, '2f/i', 'in_scale'),
        ]
    )</code></pre><p>注意到这一段创建子弹的代码中的"/i",说明了上面的顶点是重用的,而下面这一堆是各个子弹私有的。</p><pre><code class="language-python">        # 上传数据到GPU(连续内存,高效)
    self.position_vbo.write(positions.tobytes())
    self.angle_vbo.write(angles.tobytes())
    self.uv_vbo.write(uvs.tobytes())
    self.scale_vbo.write(scales.tobytes())
    
    # 实例化渲染
    self.vao.render(moderngl.TRIANGLES, instances=count)</code></pre><p>直接进行一个轰轰烈烈的顶点大上传,同时值得注意的是这个地方的bullet_pool直接.tobytes()从上一节中提到的连续内存空间中整个送入了VBO。</p><p>与此同时最后一行实例化渲染支持把上面这一堆参数整个放到显卡重用单次渲染,而不是一份份子弹画。</p><p>在这一通牛之大逼的操作之后,渲染方面至少在数据流通上不会有过分的瓶颈了。</p><h4 id="%E5%A5%BD%E4%BA%86%EF%BC%8C%E8%BF%98%E6%9C%89%E4%BB%80%E4%B9%88%E4%BA%BA%EF%BC%8C%E8%A6%81%E8%AE%A1%E7%AE%97%E3%80%82">好了,还有什么人,要计算。</h4><pre><code class="language-Python">    def _init_shader(self):
    """初始化着色器"""
    vertex_shader = """
    #version 330
    
    // 顶点属性
    in vec2 in_vert;
    in vec2 in_uv_base;
    
    // 实例属性
    in vec2 in_offset;      // 位置
    in float in_angle;      // 角度
    in vec4 in_uv_rect;     // UV矩形 [u_left, v_top, u_right, v_bottom]
    in vec2 in_scale;       // 尺寸
    
    out vec2 v_uv;
    
    uniform float u_y_scale;  // Y轴缩放因子
    
    void main() {
        // 缩放
        vec2 scaled = in_vert * in_scale;
        
        // 旋转
        float s = sin(in_angle);
        float c = cos(in_angle);
        vec2 rotated = vec2(
            scaled.x * c - scaled.y * s,
            scaled.x * s + scaled.y * c
        );
        
        // 平移
        vec2 position = rotated + in_offset;
        
        // 宽高比校正
        position.y *= u_y_scale;
        
        gl_Position = vec4(position, 0.0, 1.0);
        
        // 计算UV
        v_uv = in_uv_base * vec2(
            in_uv_rect.z - in_uv_rect.x,
            in_uv_rect.w - in_uv_rect.y
        ) + in_uv_rect.xy;
    }
    """</code></pre><p>我们注意到这段看着很不Python的代码。</p><p>这其实是顶点着色器代码,但是这里有个小巧思,CPU没有计算出具体的顶点位置,与之相反的,其直接把整个原始数据丢给了GPU,让GPU并行计算这一堆数据。在这一步优化后,基本彻底解放了CPU,可以为下一步编撰流程脚本做更多事情了。</p><h2 id="%E6%88%91%E6%AF%94fastapi%E8%BF%98%E5%B9%B6%E5%8F%91%E4%B8%80%E4%B8%87%E5%80%8D%EF%BC%81%E5%A6%82%E4%BD%95%E9%80%9A%E8%BF%87%E5%8D%8F%E7%A8%8B%E6%9D%A5%E5%AE%9E%E7%8E%B0%E9%AB%98%E9%80%9F%E6%89%A7%E8%A1%8C%E4%BC%97%E5%A4%9A%E8%84%9A%E6%9C%AC%E3%80%82">我比FastAPI还并发一万倍!如何通过协程来实现高速执行众多脚本。</h2><h3 id="%E5%B9%B6%E5%8F%91%E4%B8%8E%E5%B9%B6%E8%A1%8C">并发与并行</h3><p>强烈推荐阅读FastAPI的并发部分科普小漫画,不但可以学到什么是并发与并行,还能学到<strong>怎么调情。</strong></p><figure class="kg-card kg-bookmark-card"><a class="kg-bookmark-container" href="https://fastapi.tiangolo.com/zh/async/"><div class="kg-bookmark-content"><div class="kg-bookmark-title">并发 async / await - FastAPI</div><div class="kg-bookmark-description">FastAPI framework, high performance, easy to learn, fast to code, ready for production</div><div class="kg-bookmark-metadata"><img class="kg-bookmark-icon" src="https://qwqpap.com/content/images/icon/favicon.png" alt=""><span class="kg-bookmark-author">FastAPI</span></div></div><div class="kg-bookmark-thumbnail"><img src="https://qwqpap.com/content/images/thumbnail/concurrent-burgers-01.png" alt="" onerror="this.style.display = 'none'"></div></a></figure><p>ok,简而言之就是通过让权等待的方式来达到狠狠地并发效果。</p><p>我们这里使用<strong>生成器函数</strong>来达到这个效果。</p><p>什么是生成器函数,就是类似按一下动一下的函数。我们用下面这个简单的例子举例</p><p>首先是第一个生成器函数</p><pre><code class="language-Python">def stage_script():
print("🎬 关卡开始!生成第一波敌人")
yield "第一波敌人数据"  # 👈 暂停!函数在这里“存盘”,并把数据丢出去

print("🔄 玩家击杀了第一波,继续向前走")
yield "第二波敌人数据"  # 👈 再次暂停!

print("🏁 关卡结束!")
# 函数执行完毕,后续再调用 next() 会抛出 StopIteration 异常

注意到这函数没有return啊,其实是yield取代了return,每次调用生成器实例的next都会执行到下一个yield。

什么意思呢

# 1. 拿到生成器(此时一句话都不会打印)
coro = stage_script()

2. 按第一次播放键

res1 = next(coro)

控制台打印: 🎬 关卡开始!生成第一波敌人

res1 收到: "第一波敌人数据"

3. 按第二次播放键

res2 = next(coro)

控制台打印: 🔄 玩家击杀了第一波,继续向前走

res2 收到: "第二波敌人数据"

通过这种方式就能让脚本能够假装主动地让出CPU时间给别的不闲着的脚本。

我们大大方方查看StageManager写了什么:

IO时让出你的CPU

对于大量IO的操作,必须给他狠狠地yield出来!

#  阶段 1:加载画面 

self.loading_info = { ... } yield # 👈 第一次停顿:让游戏主循环有机会拿到 loading_info,把“Loading...”画面渲染到屏幕上

stage_dir = self._find_stage_directory(stage_class) yield # 👈 第二次停顿

if self._audio_manager and stage_dir: stage_bank.load_se_directory(se_dir) # 💿 消耗时间的磁盘 I/O(读音效文件) yield # 👈 第三次停顿:读完音效喘口气,让画面刷新一下,防止游戏界面卡死

stage_bank.load_bgm_directory(bgm_dir) # 🎵 注册 BGM</code></pre><h4 id="%E5%85%B3%E5%8D%A1%E7%9A%84%E5%AE%9E%E9%99%85%E6%B5%81%E7%A8%8B%E5%A4%84%E7%90%86">关卡的实际流程处理</h4><p>大大方方让出时间给关卡执行,在脚本结束后进行后处理,算是非常非常经典的游戏一般流程了。这样实现的是整个游戏流程就非常线性,从头到尾依次执行。</p><pre><code class="language-python">while stage._active:
stage.update()
yield  # 👈 游戏的大部分时间,都卡在这个 while 循环里,一帧一帧地打游戏

当 stage 脚本运行完(Boss 死了/通关了)

bullet_pool.clear_all() # 🧹 清空满屏子弹

停留 120 帧(大约 2 秒),让玩家缓一缓

for _ in range(120): yield # 👈 游戏通关后的结算/黑屏淡出时间

自动加载下一关

next_stage_cls = getattr(stage, '_next_stage_class', None) if next_stage_cls is not None: self.load_stage(next_stage_cls) # 🔄 协程套协程,套娃开始!

喜欢sleep的奶龙你完蛋了

不要在关卡内写任何sleep,Sleep是不让权等待,会阻塞整个游戏。

所以提供了这个方法

def wait(self, frames):
"""等待指定帧数(生成器函数)"""
for _ in range(frames):
yield

在游戏内直接

def boss_ai_script(ctx, stage_manager):
# 1. 移动到屏幕中央
boss.move_to(0, 0.5)

# 2. 引擎,请帮我在这里卡 60 帧(1秒),让我摆个 Pose
yield from stage_manager.wait(60)  # 👈 借用 wait 函数

# 3. 释放第一阶段符卡
ctx.play_se("spellcard_declare")
boss.start_spellcard_1()</code></pre><p>这样来<strong>让权等待</strong>。</p><p>在这一套又一套的套套中,就能组织起来无比复杂的弹幕脚本逻辑了。</p><h2 id="%E6%8F%8F%E8%BF%B0%E6%80%A7%E6%B8%B8%E6%88%8F%E8%B5%84%E4%BA%A7">描述性游戏资产</h2><p>懒得写了,,,,</p>

东方Project同人例会录制/直播指北

前言

遗憾的,虽然之前许多北京地区的东方例会都是我录制和直播,但是我要毕业了。

如果有错误内容请务必向我指出,发送邮件给我就好

[email protected]

这篇文章旨在让大家能够少踩坑,在尽可能减少预算的前提下最高质量地保存这一美好的活动回放。

注意,前提是你需要有一台支持外录功能的相机,这并不会特别昂贵。

相机

这一部分会简要介绍相机的传感器,镜头焦距,以及其对于录制的影响,如果你已经熟练了解这一部分,请直接跳过

认识你的传感器尺寸

通常我们以“全画幅”为标准,全画幅相机通常意味着比较多的进光量,也就意味着更好的画质,当然这不是必须的。

所以还会有“半画幅”,也叫做APS-C画幅,字面意思其传感器尺寸会小一些,与此同时画质会略弱(相对吧)。

再在这之下还有M43画幅,一英寸画幅,这都更加迷你了。通常在小于M43画幅的机器可能使用的是“不可更换镜头”

关于镜头我们最需要关注的是焦段。

认识你的镜头焦段

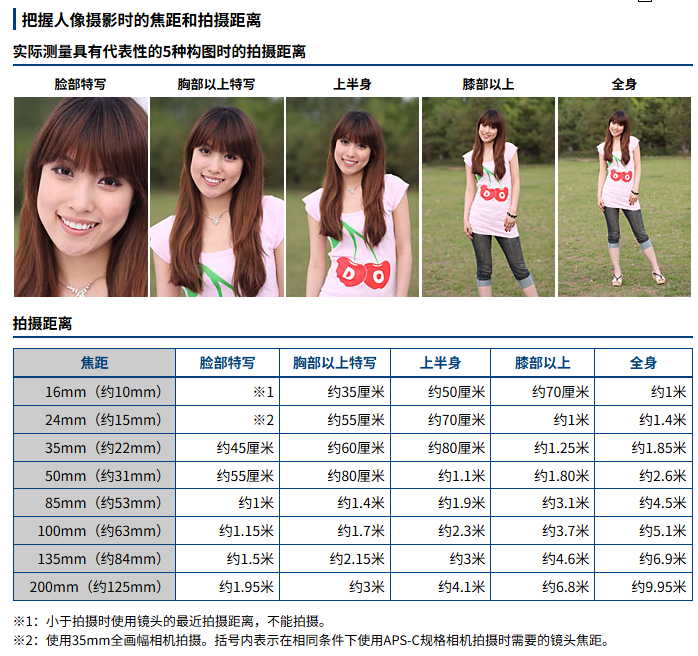
通常我们以全画幅机器为所有焦段的标准。越长的焦段,你能录制的范围就越窄,也就是最直观的”放得越大“,让我在这里引用佳能的一个小图片。

那么同样的,对于焦段越小的镜头,其能录制的就越广。

如果想要变大变小不得了,你需要变焦镜头,这也是录制例会最理想的镜头类型,通过变焦这个操作来实现可以放大拍特写,也可以缩小拍全景。

这里有一些值得注意的点。

首先是光圈,不可避免的光学问题导致变焦镜头光圈会小一点,所以理所应当导致进光量小,画质差一些。这里就不赘述虚化问题了,一般录制过程中不会有大的影响。

其次是镜头的焦段推荐,一般我认为需要在32mm以下到最大100mm以上的变焦镜头是比较方便的(这里是全画幅的焦段)

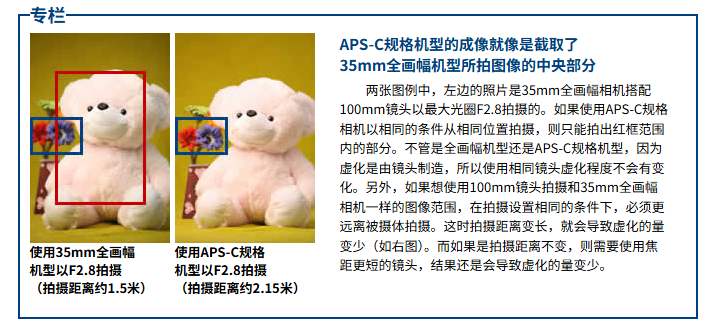
如果你的画幅不是全画幅,注意注意,需要把镜头的物理焦段乘上具体的裁切系数才是实际的焦段,这需要你自己查。

必要的外部设备

在开始录制之前,你必须要准备必要的外部设备来支持这一场非常长久的录制。

电脑

为了录制和直播,电脑是必不可少的,需要安装一个叫做OBS的软件,这个我们之后再慢慢说。

同时,电脑的硬盘需要足够大,通常对于一般半天的东方例会我推荐500GB以上的剩余磁盘大小。

三脚架

我去哥们,你总不能用手端着吧。

你需要一个自己用着舒服的三脚架,这并没有什么特别的要求,非常主观,自己高兴就好。

记得带上快拆版。

假电池

如果 如果你的廉价老相机的供电接口并不稳定,还容易越冲越少,你需要假电池。

虽然现在的相机电池看着都巨大一坨,比如fz100什么的,但是你没电了总得换,不能说录制的时候黑屏十秒钟我换个电池哈。那肯定炸了,所以你需要外部供电或者是假电池,假电池就是一块插在充电宝上的电池,请自行淘宝你的相机电池型号+假电池。

注意注意,为了你的相机安全,不要买太便宜的假电池。

假电池的使用各家不相同,对于索尼我记得是需要先给假电池通电再塞入相机。

采集卡

你需要采集卡来把相机HDMI输出的内容通过转码放到电脑的视频输入里面,这样才能被其他软件所处理。一般1080p60fps采集卡不会超过100块,如果比较有追求可以买个4k的,在这之前请确认你的相机支持这么高画质的输出。

录音

从来没有人在意的部分就是录音。

事实上录音及其重要,例会现场吵得要死什么都听不清楚,为了最佳的直播/录制效果,务必购买无线麦克风。

不是广告,但是我推荐买个大疆的无线麦克风,比如我自己用的DJI mini mic,几百块吧,非常非常非常好用。

把麦克风放在讲台或者夹在主持人的领子上面,然后接收端怼入你的相机音频输入即可,如果想要听一下效果可以带一个有线耳机插入你的相机监听接口品鉴一下效果。

无论如何,记得关注你的录音质量,不然回放就是废的。

把视频放到电脑

相机上的设置

由于笔者只有索尼相机,这里以索尼A7R3为例子。

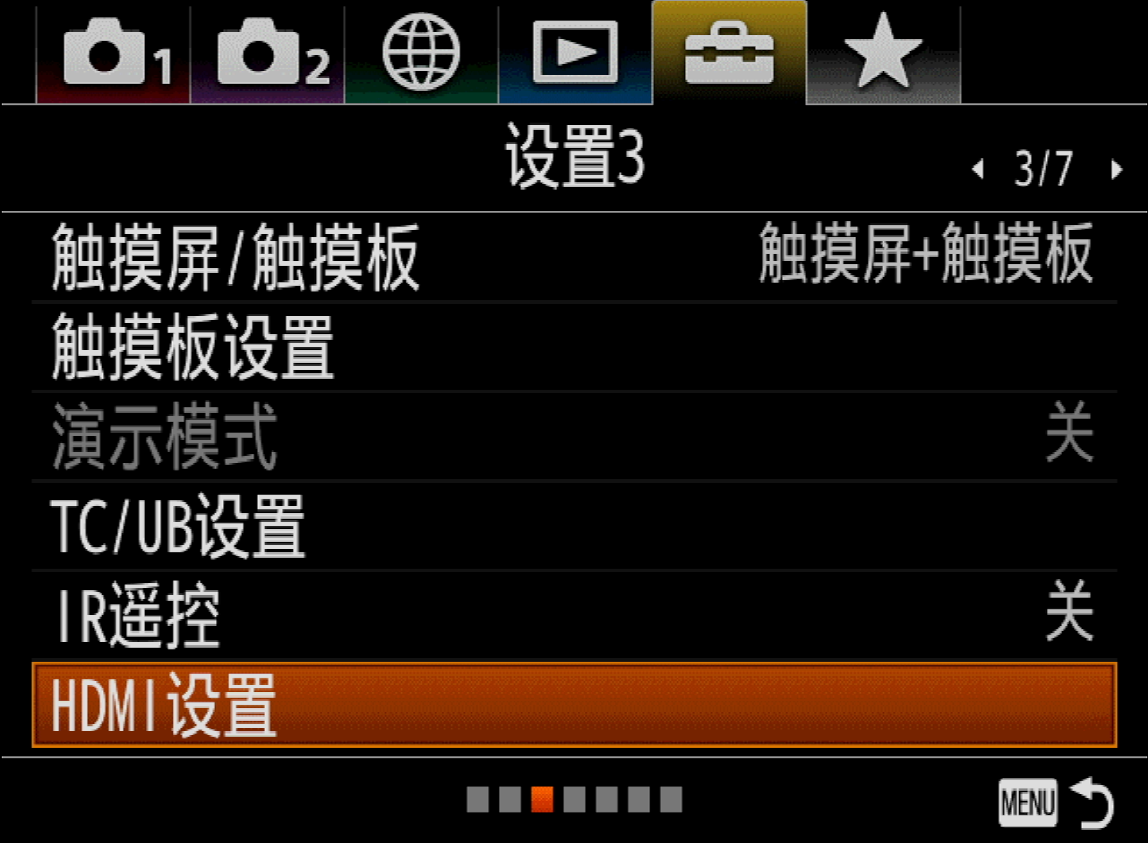
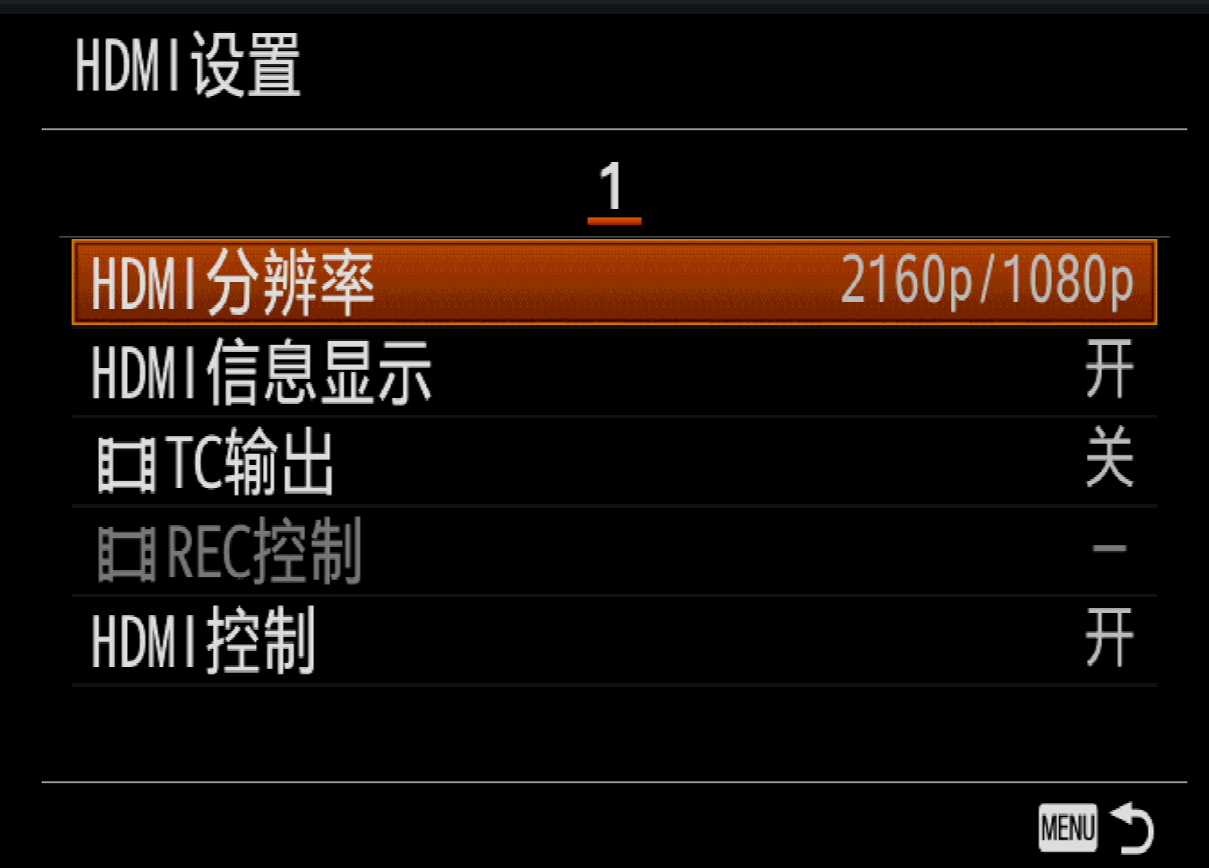
HDMI设置

找到HDMI设置

记得把信息显示设置为”关“

这里我开着是为了从电脑截图设置界面

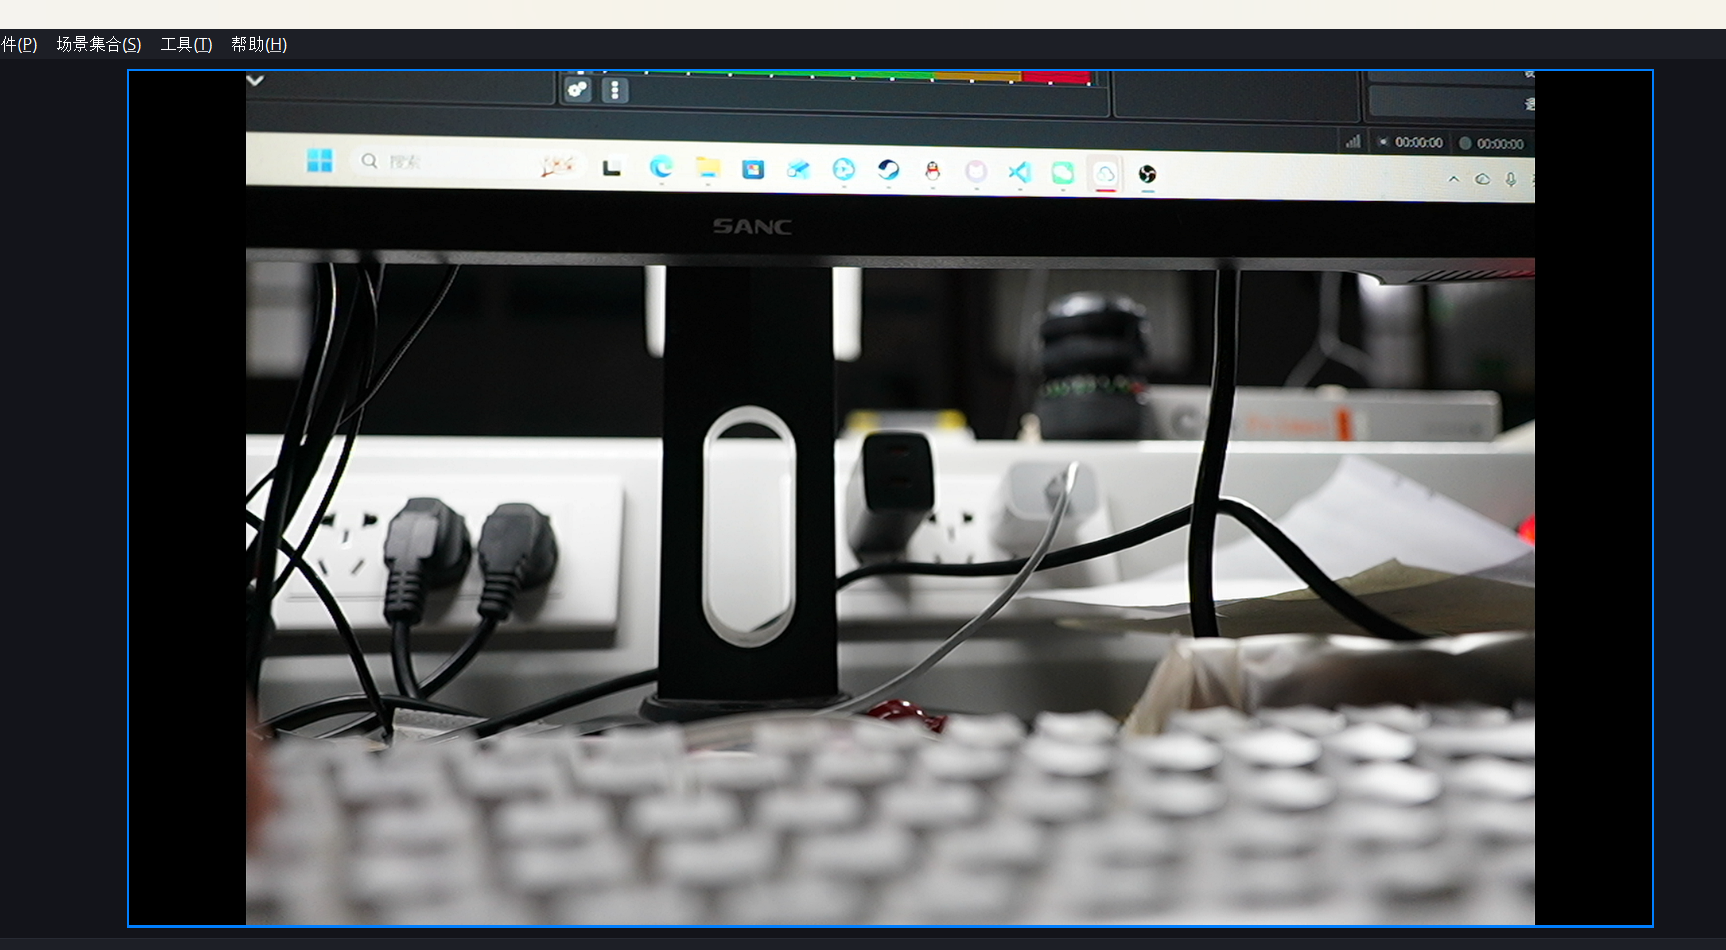
如果设置为关之后,电脑上应该只有纯净的视频输出画面了

物理连接

你需要阅读你的相机说明书,来确定自己相机的视频输出接口是什么型号的,对于很多微单,都是MircoHDMI接口,这需要你买一个转接线让他变成HDMI接口,这样才能被采集卡所认识。

把采集卡另一端怼到前文提到的电脑里面,就可以开始下一步了

视频帧率设置

你如果在中国大陆阅读这篇文章,那么理所应当的,你所在的电网是50hz,为了不让你最后录制的效果是全场爆闪,务必!让录制的fps=50/25,如果你非要用30/60fps,务必务必确保你的快门速度是1/50。为此,你需要使用,快门优先+自动iso的设置。

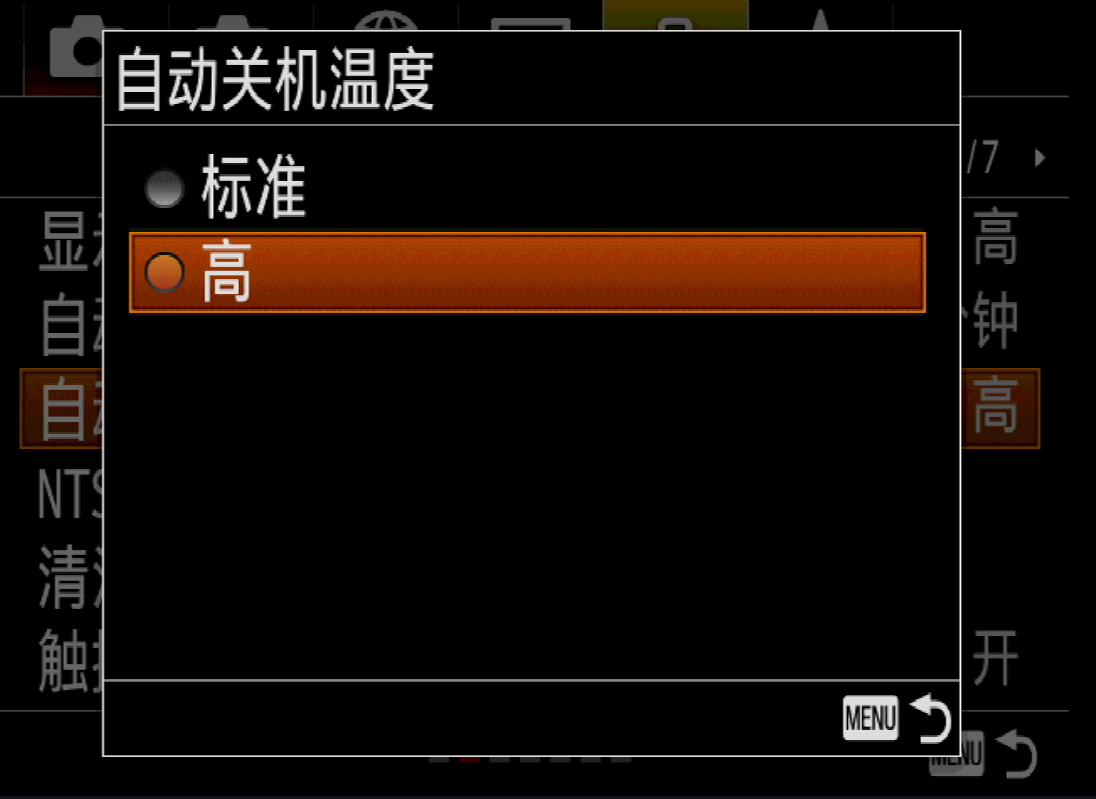
关掉过热保护

如果你恰好还在用索尼相机,记得把自动关机温度设置为 高。

不然录一会悄悄就关机了。

设置为视频

最后一步就是设置到录制视频那个模式,不用开始录制,输出的画面就已经是我们需要的了。

OBS!

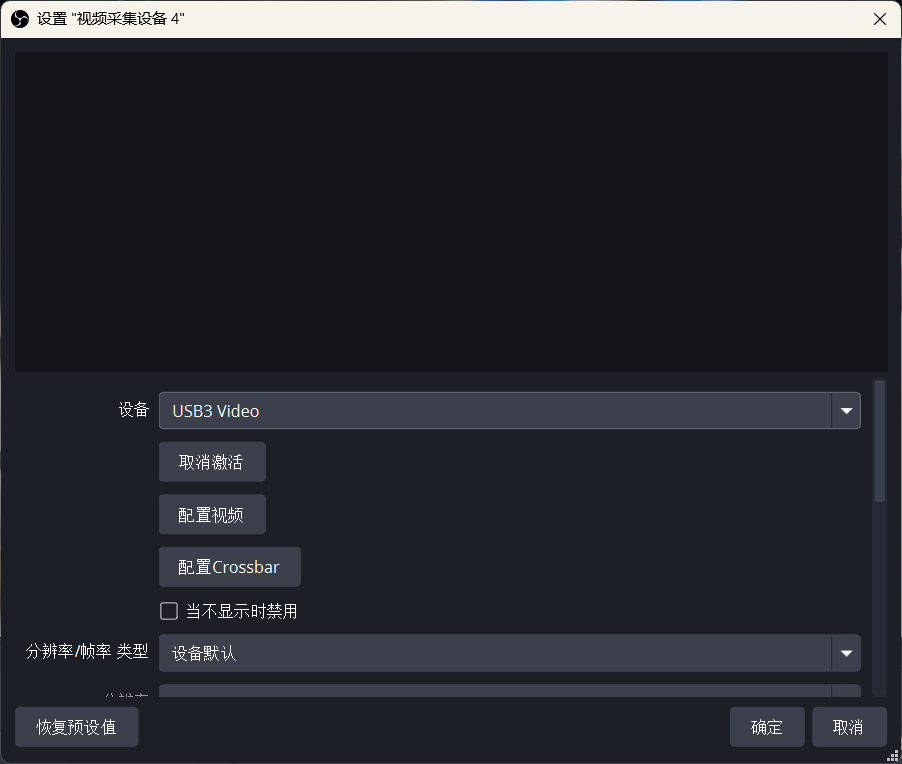
在OBS窗口中选择 ”源“的加号,点击视频采集设备,在下面这个窗口选择你的采集卡名字。

之后如果连接正确就能在电脑看到你的相机画面。

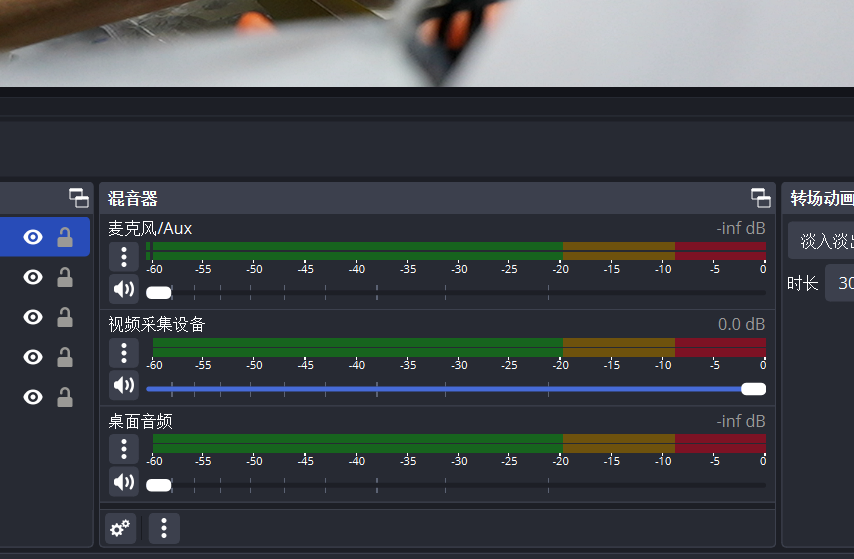
如果有的话,记得在混音把你的电脑麦克风和电脑声音设置为0

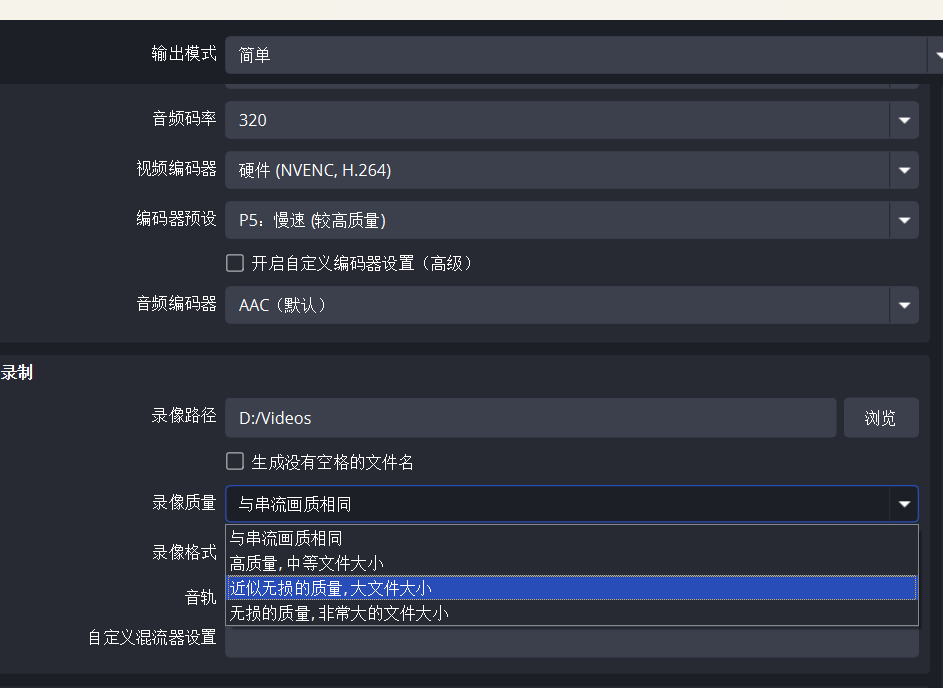
对于录制的设置,我强烈强烈不建议使用”无损的质量“,这会让你的剪辑工作直接爆炸。

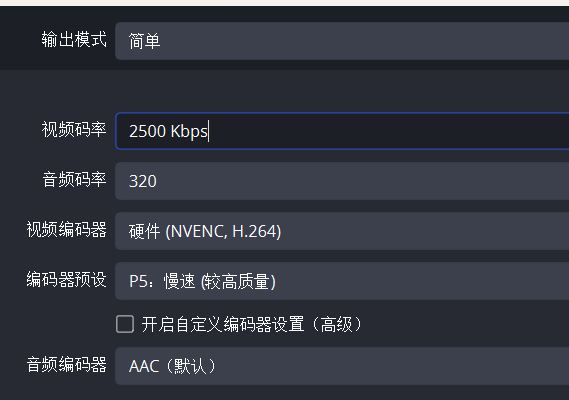
对于直播的视频码率,我推荐你试一试,各个学校的网络情况亦不相同。

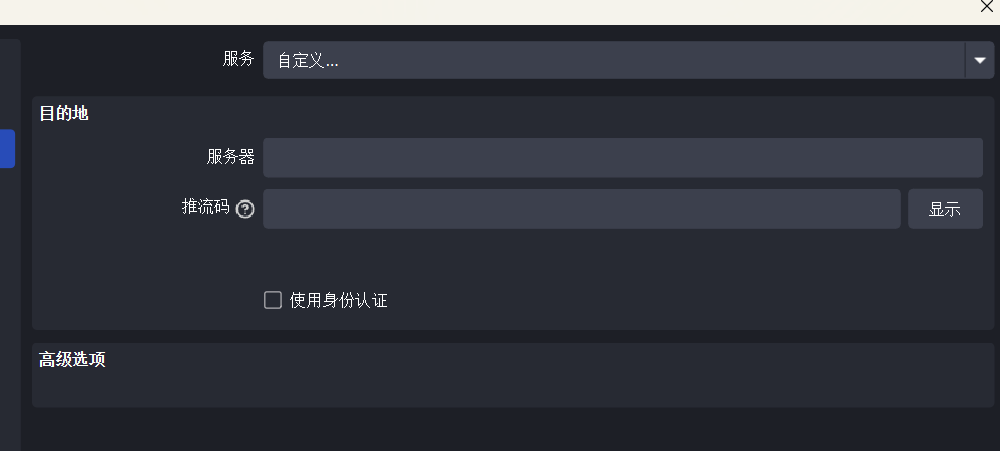
之后是设置推流码,通常在直播的平台会给你这个,如果你恰好决定用bilibili直播,你可以大大方方说陈睿你妈死了,因为现在好像不怎么提供推流码。

彩排!

无论如何,在例会开始前,你应该用例会会用的所有set,做一次直播和录制的检查,为了不把录像炸飞,也为了你不会身败名裂。

无论是网络异常,投屏爆炸,电线断了,务必务必测试一下会不会发生。

其他消息

企业级运镜

关于你要什么时候放大什么时候缩小,我只能说自己探索,通常在类似相声,朗诵,演奏,你需要对准他们狠狠特写,对于台上台下一起唱歌之类的互动,那还是缩小点,全景好。

备份

不是必要的,但是我推荐拿个运动相机,手机等等放在旁边录制,如果不幸的,你的相机录一般死翘翘了,那还有挽救的机会。

如果你内存卡大,可以同时内录一份在机内。

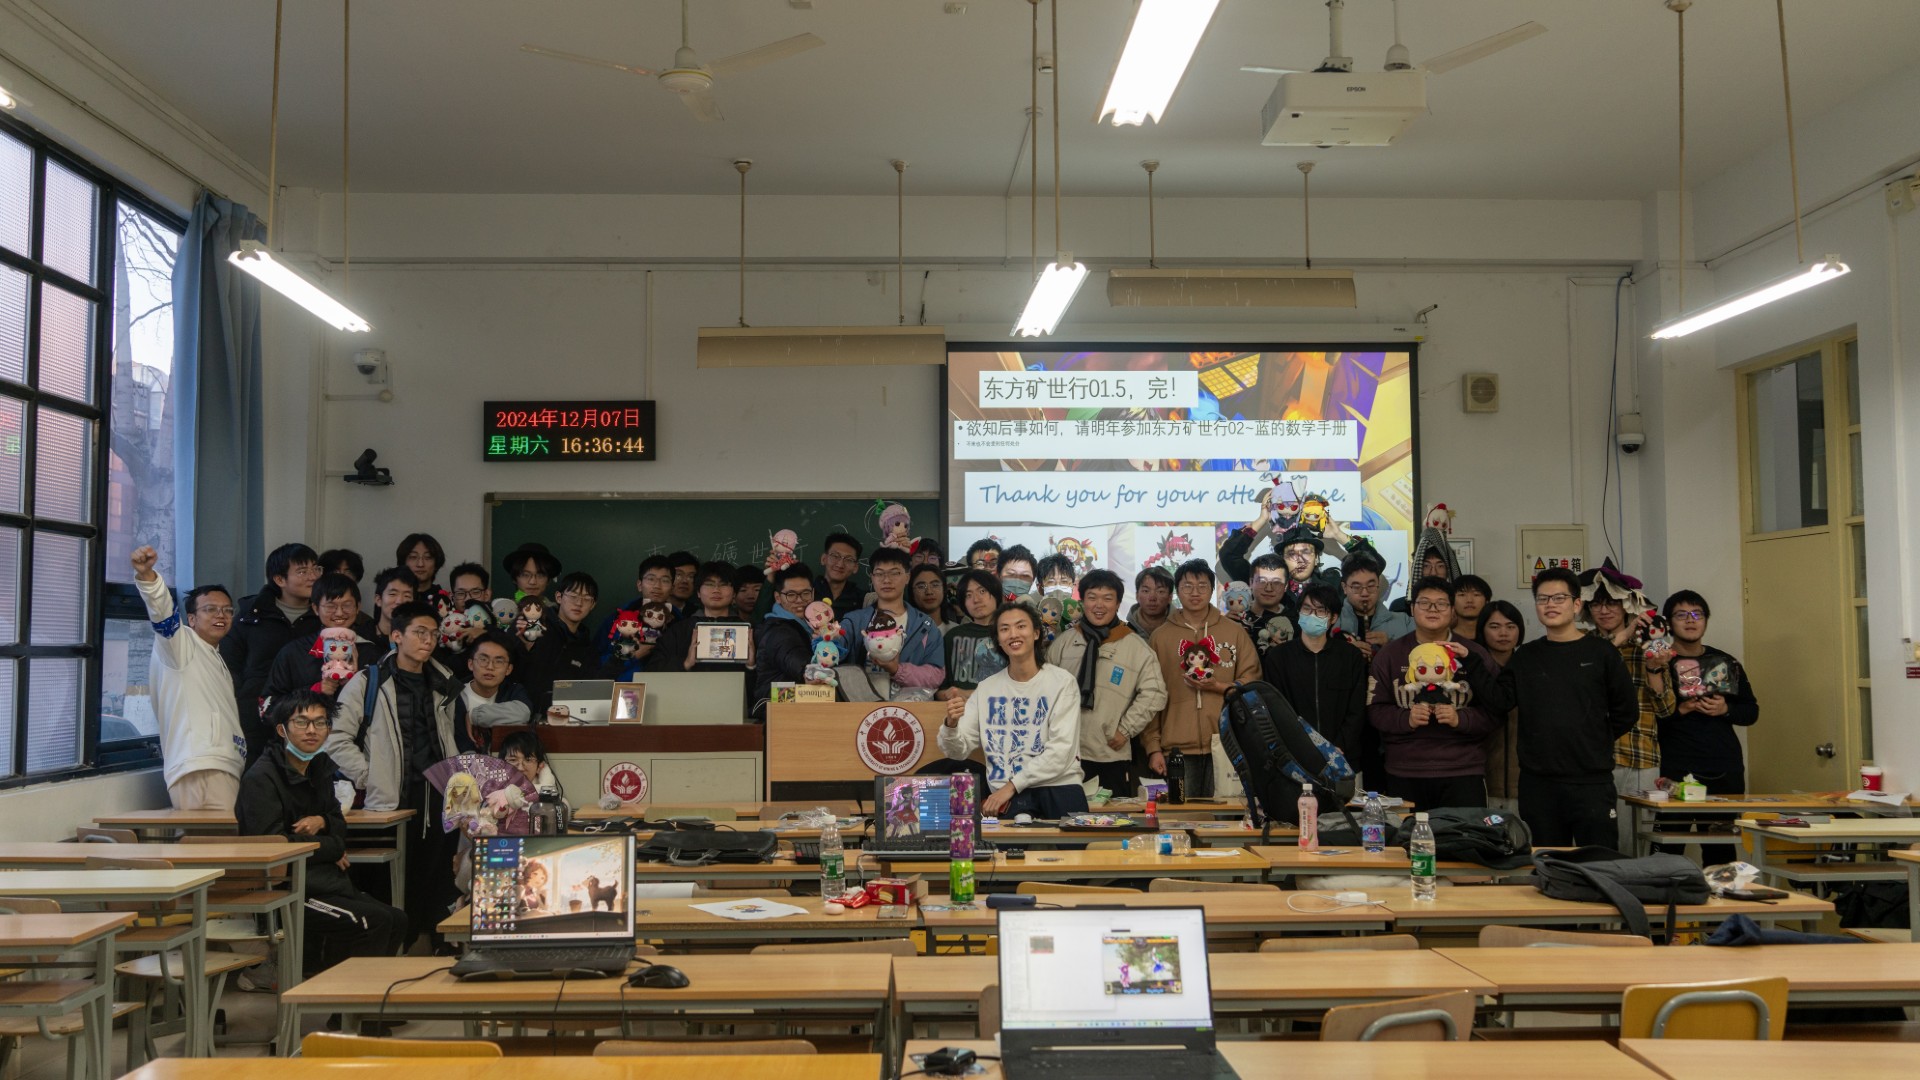
合照

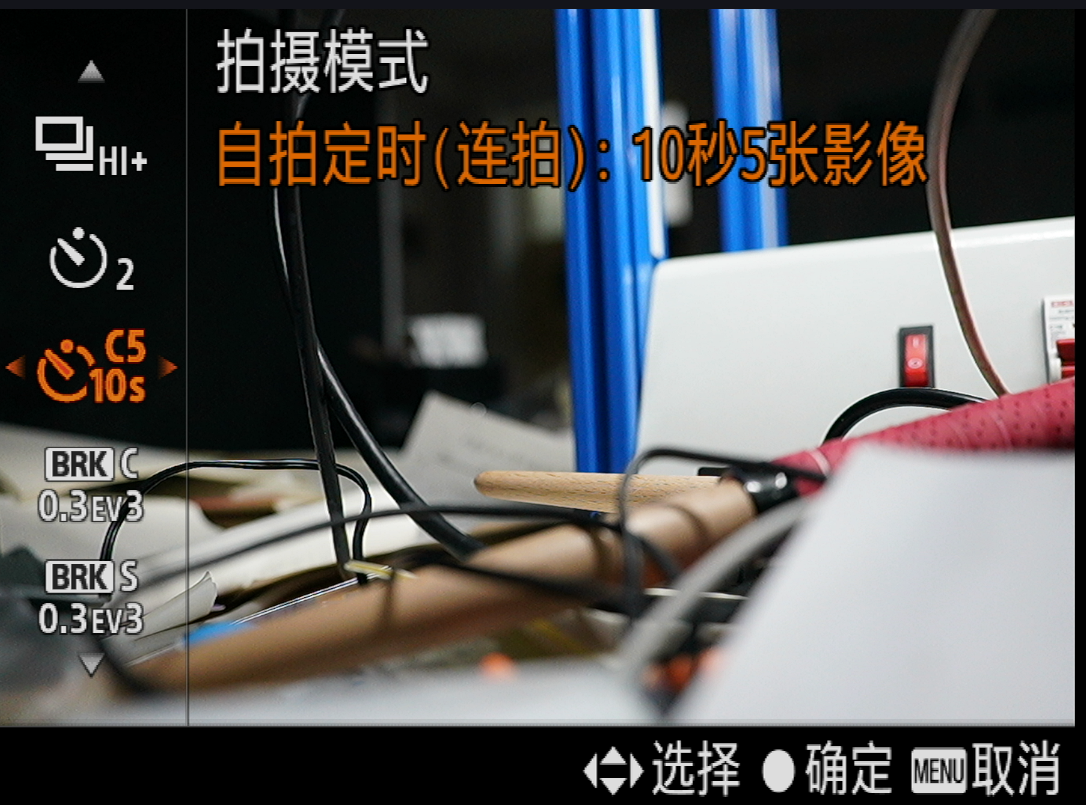
通常你那个位置会被要求帮忙拍个合照,选择自拍定时,十秒就好,在这之前记得同样的,设置快门优先,给到起码1/50,然后iso自动,记录raw格式。

记得 关掉 PPT,不然人的脸上会有PPT的内容。

最后,祝你玩得愉快。

张量分析大观

前言

其实是这个B课重修了,正好考完研仔细研究一下到底在说什么事情,也借这个机会好好复习一下一些基本的张量表示方法。

张量是怎么来的

标量-0维张量

在最开始的时候,初中物理接触到的东西是非常简单的物理量,举一个小例子

对于均匀连续物体的密度与质量,满足以上一个简单的表达式。

我们会说密度与质量都是一个标量,标量代表着它没有任何的方向性,是一个很单纯的数字。

那我们更进一步,注意到这个式子

似乎也是一个标量表达式,但是隐隐约约似乎还记得电流是有方向的,于是我们引入带有两个方向的电场强度这个变量。

矢量-1维张量

对于经典的:物体的动量,我们还记得这个式子

这个式子中动量与速度都是一个带有方向与大小的矢量

矢量我们可以给它写开,比如三维情况,速度就会有三个分量,二维就有两个,但是注意

我们说的现实世界的维度和张量的维度没有任何关系,此处的矢量依旧是一个一维的张量。

二维张量

其中σ是电导率这个单位。

所以这个时候需要思考的是,电导率要如何表达出来。

对于各向同性材料,不难想象,电流的方向与电场的方向一定是一致的,也就是说σ可以是一个简单的数字就好。

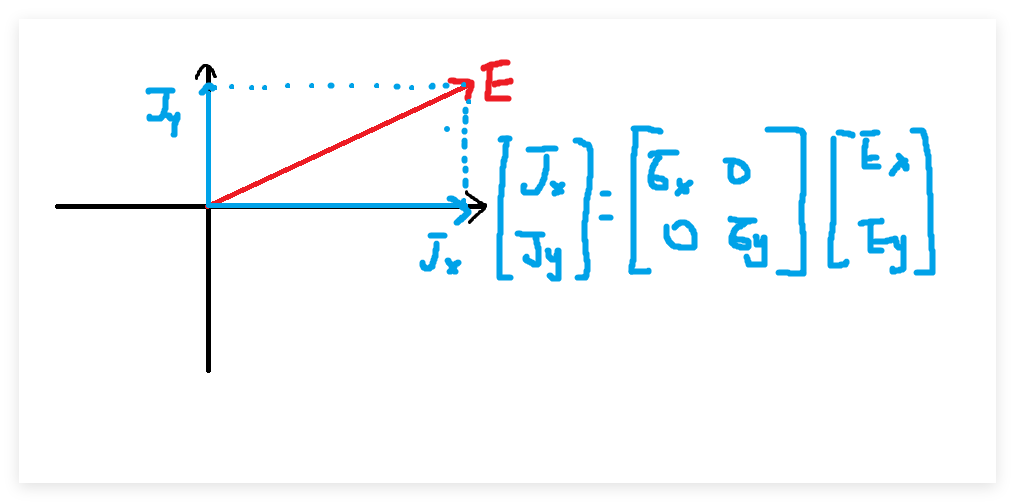
但是我们假设(实际也确实有这种材料)一种材料,其在x方向上拥有良好电导性,y方向完全不具备导电性。

如图,不难发现需要两个电导率相关的参数来表示这个线性变换。

但是这两个0它应该是0吗?

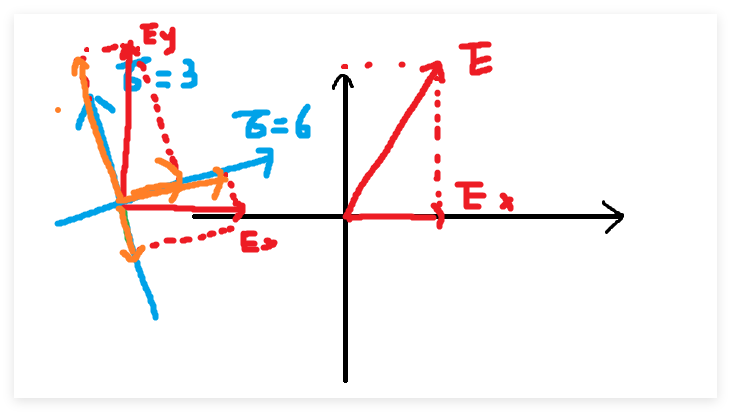
学过线性代数的好厚米可以瞬间发现,我们所选的坐标正好是矩阵的基向量组合,并不具有很好的普遍性,于是我们换一个普遍情况来看看:

此时我们注意到,对于任意的x方向与y方向的电场强度,任意一个方向的电场强度都会同时在坐标轴的两个方向产生一个不同的电流强度。

如果没有看懂,也能注意到图上至少出现了四个变换后的电流强度,如何描述这种变换呢。

注意到此时σ是一个下标含有两个坐标的分量,让我们用矩阵乘法来把这个表达式拆开

最好的看待方式就是发现其实

就是在说:Y方向的电场强度会对x方向的电流强度产生如何之影响

特别特别要注意的是,这个地方的“二维张量”说的是任意一个分量的维度。

同样是上面这个式子,在三维中的表达式如下,但是我们依然注意到对于x方向的电导率是一个平面,也就是x,y,z三个方向的电场强度在这个平面上的影响,这并不会受到具体选择几维坐标而改变

举一个力学中常见的概念:

应力

在弹塑性力学中,应力是如下规定:

可以注意到这个地方的应力应该是一个带有方向的矢量。

在材料力学中知道,一个力在切向与轴向的作用效果是完全不同的(考虑一下切蛋糕和压扁蛋糕似乎不太一样)

所以我们需要描述的是,任意一个力要如何表示为一个应力。

对其在各个方向上分解后,任意方向力依然会同时作用于三个方向,所以我们需要引入应力的张量表示法:

当然这里涉及线性代数与应力不变量的内容可以参看本站内塑性力学相关笔记

编辑文章 「塑性力学期末速通速查手册」 ‹ ベルベットルーム — WordPress

但是总之我们会得到这样一个式子

这个地方的σx其实是把两个x写到一起了,用τ来代表这个是切应力的意思,当然这里不用关注力学细节,主要是要知道二维的张量在一个变换中能够把一个矢量变成另一个矢量。

一些至关重要的性质

  • 张量与你选择的坐标系没有关系
  • 张量的变换是线性变换

这个看着也很眼熟,我们从一点应力状态中的“应力不变量”来展开稍微说说,当然这部分不是很重要,只是我想说说。

由于切应力的对称性质,我们知道应力张量在矩阵中是一个实对称矩阵,实对称矩阵我们可以化为标准型,而关于主应力有以下之性质

经过任意一点P的某一斜面上的切应力为零,则该斜面上的正应力成为主应力,该斜面的法线方向成为主应力方向。

所以其实主应力就是把原有应力张量化为标准型矩阵后的三个特征向量和特征值,特征向量就是正交的主应力方向,而特征值就是主应力大小,所谓应力不变量也就是相似矩阵所得到的性质。

爱因斯坦求和准则

因为懒狗物理学家都不爱写算式,为了大大方方偷懒,有一些必须学习的简写规则与方法。

基本上我们有四条准则:

第一条:哑指标与自由指标

考虑以下表达式

在每个单项式中最多出现了两次的下标 j 就是哑指标,而只出现了一次的 i 代表自由指标。

其代表了以下之求和表达式:

第二条:自由指标不代表求和,代表出现的次数,不能替换为别的字母

第三条:任何一个单项式中不得出现两个以上的相同指标:

以下形式是绝对不允许的:

这么写包写错了的。

当然虽然没涉及到 但是上标也算在这个范围内

依然是不允许的情况

第四条 对于等式,左右的自由指标必须是一致的。

一些别的约定

乘法表达式

考虑以下表达式

在处理括号的时候,需要优先把括号内的东西直接拼在外面,注意不是乘在外面

这个时候对于每一个表达式中出现的指标次数进行计数,取每一个指标在最高出现次数的子项中的次数为指标计数,再用这个来代表其类型。

比如上文中i,j都出现了两次,是哑指标,而k出现了一次,是自由指标

对于哑指标可以任意替换其符号,用这个可以实现一点看着像是轮换对称性的操作。

如果出现了两个哑指标,那么一次就应该产生九个子式子。

克罗内克符号

这个可以快速筛选出主对角线上面的元素。

通常一个克罗内克符号可以消灭一个哑指标,举个例子

同样的,这个可以用来替换指标:

两个克罗内克符号可以消灭中间那一个

ConvNext品鉴-东方Project角色识别

前言

为了给例会群里搞点乐子,于是决定搞一个东方角色的识别,首先想到的其实就是ConvNext网络,对于这个一百来个角色的分类任务,它足以胜任。

ConvNext网络介绍

(99+ 封私信 / 90 条消息) ConvNeXt—— 一个能挑战 Vision Transformer 的卷积神经网络(万字长文,从原理到代码演示) – 知乎

懒得介绍了,看看知乎得了

数据来源

预期的角色数量大概在120多人,有一些旧作的角色可能被狠狠抛弃了。

事后发现纯狐和三花也被忘掉了)

每个角色大概100多个图片,最开始的数据集来自于Preacher-26/touhou-embeddings-dataset · Datasets at Hugging Face

特别感谢Preacher老师的分享。

之后再次获得了Renko_1055的神秘python脚本,使我的数据集数量获得了极大的提高。

稍微修改一下

对于原版的ConvNext,我们需要给最后一层网络直接改成全链接到所有的角色上面输出一百多个预测值。